SSML guide : contrôler la prononciation TTS avec le balisage vocal

Camille Renard
octobre 21, 2026 · 16 min de lecture
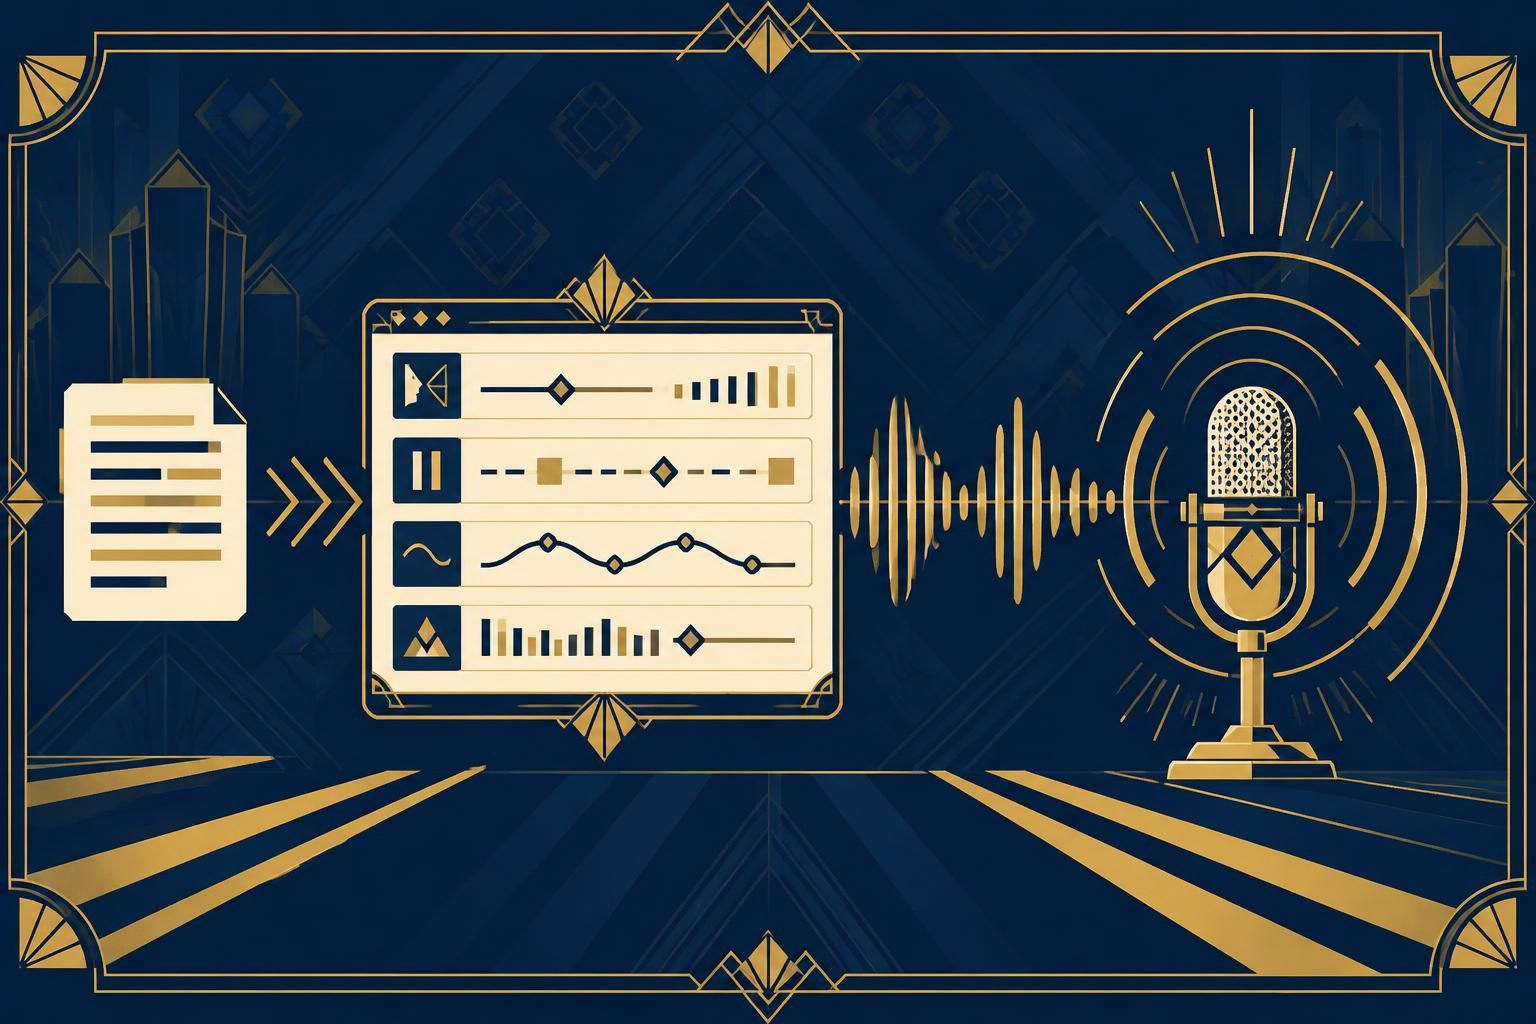
Un nom propre mal prononcé, une date débitée sans naturel ou une pause placée au mauvais endroit peuvent réduire la qualité d’une voix de synthèse. Le balisage SSML permet de corriger ces détails en donnant au moteur des indications précises sur la voix, la prononciation, l’intonation et le rythme. Il transforme un texte ordinaire en consignes de lecture que certains services de synthèse vocale savent interpréter.
Pour une entreprise, ce contrôle a des effets concrets : un message d’accueil plus clair, une formation audio plus agréable ou un livre audio moins monotone. Mais SSML n’est pas une formule universelle. Les balises disponibles et leur comportement varient selon le fournisseur, la voix choisie et le type de synthèse utilisé. Un réglage valide sur un service peut être ignoré par un autre.
En bref
-
SSML sert à guider une voix TTS : prononciation, pauses vocales, débit, volume, hauteur et expressivité.
-
Les balises courantes incluent <break>, <prosody>, <phoneme>, <say-as> et <voice>.
-
La prise en charge dépend du moteur : vérifiez les règles du service avant de préparer un document complet.
-
Le meilleur contrôle vocal vient d’essais courts, écoutés sur le support final, puis corrigés par étapes.
SSML et synthèse vocale : à quoi sert le balisage vocal ?
SSML signifie Speech Synthesis Markup Language, ou langage de balisage pour la synthèse vocale. Ce format ajoute des instructions à un texte afin qu’un moteur TTS ne se contente pas de lire les mots dans l’ordre. Il peut, selon ses capacités, distinguer les phrases, marquer une pause, prononcer un nombre comme une date ou modifier la prosodie d’un passage.
Imaginez une boutique en ligne qui transforme ses consignes de livraison en messages audio. Le texte « Votre colis arrive le 04/06 à 14 h » peut être interprété de plusieurs façons : le moteur peut lire les chiffres séparément ou comprendre une date et une heure. Une balise adaptée aide à préciser l’intention, tandis qu’une écoute de vérification confirme que le résultat convient réellement aux clients.
Le document SSML repose généralement sur une balise racine <speak>, qui encadre le contenu à vocaliser. À l’intérieur, des éléments structurent les paragraphes et les phrases, tandis que d’autres modifient certaines caractéristiques de la voix. Le SSML ne remplace donc pas la rédaction : un texte clair reste indispensable, même lorsque le moteur dispose de nombreux réglages.
Les moteurs ne reconnaissent toutefois pas tous les mêmes instructions. La documentation de SSML pour Azure Speech détaille, par exemple, des éléments et attributs propres à cet environnement. Pour une première vue des balises et de leurs usages, le guide d’ElevenLabs consacré au SSML constitue un autre point de comparaison utile.
-
Structure : les balises organisent les phrases et les paragraphes pour mieux guider la lecture.
-
Prononciation : des instructions phonétiques peuvent aider avec les noms de marque, les sigles ou les termes spécialisés.
-
Rendu : la prosodie et les pauses vocales donnent davantage de relief aux informations importantes.
Une équipe marketing qui prépare une annonce audio a donc intérêt à définir d’abord le résultat attendu : compréhension immédiate, ton rassurant ou lecture rapide. Le balisage vient ensuite préciser ces choix, sans les remplacer. Le point essentiel est simple : SSML contrôle la manière de parler, mais la qualité du résultat dépend aussi du texte et de la voix sélectionnée.
Les principales balises SSML pour régler prononciation et pauses
Structurer le texte et insérer des pauses vocales
Les balises <p> et <s> permettent de délimiter des paragraphes et des phrases dans les services qui les prennent en charge. Cette organisation aide le moteur à interpréter les enchaînements et facilite les retouches. Pour marquer un silence, <break> est souvent la solution la plus directe. Une consigne comme « Votre rendez-vous est confirmé » gagne parfois à être suivie d’une courte pause avant les détails pratiques.
Une pause ne doit pas être ajoutée mécaniquement après chaque phrase. Trop de silences fragmentent le message et donnent une impression artificielle. À l’inverse, une suite de consignes prononcées sans respiration peut compliquer la compréhension, notamment au téléphone. Pour une annonce de service, placez une pause après la confirmation principale, puis écoutez si la transition vers l’adresse ou l’horaire paraît naturelle.
Corriger la prononciation avec phonétique et say-as
La balise <phoneme> peut indiquer une prononciation phonétique lorsqu’un nom propre ou un mot rare pose problème. Sa syntaxe et les alphabets acceptés dépendent du service. Il faut donc vérifier le format demandé par le fournisseur plutôt que recopier un exemple trouvé en ligne. Pour un nom de produit, plusieurs essais avec une personne francophone valent mieux qu’une correction approximative.
<say-as> sert à préciser la nature d’une donnée, par exemple un nombre, une date ou un sigle, lorsqu’un moteur propose cette interprétation. Une adresse, un code de suivi ou un numéro de téléphone ne se lit pas toujours comme un nombre courant. Le choix de l’interprétation doit correspondre à l’usage : un numéro de dossier doit rester intelligible chiffre par chiffre, alors qu’un montant peut être lu comme une somme.
Le guide de SSML de Google Cloud Text-to-Speech présente également les balises disponibles dans son service. Pour garder un repère rapide, voici les fonctions les plus utiles en production, sous réserve de compatibilité avec la voix retenue.
| Besoin | Balise courante | Usage typique | Vigilance |
|---|---|---|---|
| Marquer un silence | <break> | Créer une pause entre deux informations | Éviter les silences trop fréquents |
| Modifier le débit | <prosody> | Ralentir une consigne importante | Tester la fluidité à l’écoute |
| Guider la prononciation | <phoneme> | Préciser un nom ou un terme spécialisé | Vérifier l’alphabet phonétique accepté |
| Interpréter une donnée | <say-as> | Lire une date, un nombre ou un sigle | Choisir le mode adapté au contexte |
| Choisir une voix | <voice> | Définir le locuteur d’un passage | Contrôler les voix compatibles |
Pour comparer les balises avec des exemples complémentaires, le guide SSML de FreeReadText peut servir de ressource de consultation. Une balise n’améliore cependant le message que si elle règle un problème audible : commencez par l’élément qui gêne réellement l’écoute, plutôt que d’accumuler des effets.
Contrôler la voix TTS avec prosodie, intonation et expressivité
Régler le débit, la hauteur et le volume
La balise <prosody> peut modifier le débit, la hauteur ou le volume lorsque le moteur accepte ces paramètres. Ces réglages influencent directement la perception du message. Une voix légèrement plus lente peut clarifier une procédure, tandis qu’un changement de hauteur trop marqué peut détourner l’attention du contenu. Les valeurs sont interprétées selon les règles du fournisseur et ne produisent pas toujours exactement le même effet d’une voix à l’autre.
Pour une formation interne, une cadence régulière aide les collaborateurs à suivre les étapes. Pour une publicité, une variation modérée de l’intonation peut mieux distinguer une promesse d’une précision tarifaire. Dans les deux cas, il faut écouter la version finale plutôt que se fier au seul code : une vitesse théoriquement adaptée peut sembler trop lente sur un casque et acceptable sur un haut-parleur de téléphone.
Accentuer les mots sans surjouer le texte
L’élément <emphasis> peut mettre un mot en relief lorsque la voix et le service l’autorisent. Il sert à signaler une information clé, comme une date limite ou une consigne de sécurité. L’emphase est plus efficace lorsqu’elle reste rare. Si chaque phrase insiste sur plusieurs mots, le message perd sa hiérarchie et devient fatigant à écouter.
Certains services proposent aussi des styles vocaux ou des rôles. Dans la documentation Microsoft, par exemple, des paramètres particuliers permettent de demander un style de lecture ou d’ajuster certains attributs de la voix. La liste exacte des options dépend du modèle choisi : une balise non prise en charge peut être ignorée ou provoquer une erreur. Un fichier bien formé n’assure donc pas, à lui seul, un rendu identique partout.
Pour découvrir comment les commandes SSML se traduisent à l’écoute, une démonstration vidéo sur la synthèse vocale et ses balises peut compléter la lecture. Elle aide à comparer une phrase neutre avec une version où le débit, les pauses vocales ou l’intonation ont été modifiés.
Une petite entreprise peut appliquer une méthode simple : ne modifier qu’un paramètre à la fois, générer un extrait de quelques phrases, puis le faire écouter à deux personnes qui ne connaissent pas le texte. Si les auditeurs comprennent mieux sans trouver la voix artificielle, le changement apporte une valeur réelle. Le contrôle vocal utile est celui qui améliore l’écoute, pas celui qui multiplie les effets.
Choisir les voix, les langues et les effets audio compatibles
Un document SSML peut définir une voix avec <voice>. Selon le service, il peut aussi combiner plusieurs voix dans un même contenu, par exemple pour différencier les interlocuteurs d’un dialogue. Chaque segment doit alors être associé à la voix prévue et au texte correspondant. Cette possibilité est pratique pour un module de formation dialogué, mais elle suppose de vérifier la disponibilité de chaque voix et la cohérence du rendu entre les locuteurs.
La langue joue un rôle tout aussi important. Une voix multilingue peut parfois lire plusieurs langues, tandis qu’une voix conçue pour une seule langue peut ne pas interpréter correctement un passage étranger. Des instructions de langue, lorsqu’elles sont prises en charge, servent à préciser l’accent ou la langue attendue. Cela ne garantit pas que toutes les voix couvrent les mêmes langues ni qu’elles prononcent les noms étrangers de façon satisfaisante.
Pour un contenu destiné à plusieurs pays, évitez de supposer qu’un seul réglage convient partout. Une entreprise qui produit une annonce en français et en anglais devrait écouter séparément chaque version, vérifier les noms propres et contrôler les transitions. Une voix adaptée au français de France peut ne pas correspondre au français canadien attendu par une audience locale.
Certains moteurs acceptent également un fichier audio préenregistré, un effet sonore ou une musique de fond. Dans les environnements où cette option existe, la qualité du fichier, son accessibilité et les contraintes de durée doivent être vérifiées. Un jingle peut renforcer l’identité d’une marque, mais un fond sonore trop présent nuit à l’intelligibilité, surtout sur un téléphone ou dans un espace bruyant.
-
Vérifiez le nom exact de la voix et les langues officiellement prises en charge par le service.
-
Testez les changements de locuteur sur un dialogue complet, pas sur une phrase isolée.
-
Écoutez les effets et la musique sur le support final, notamment un haut-parleur de téléphone.
-
Gardez une version sans effets afin de comparer clairement l’apport de chaque réglage.
Si l’objectif est de produire rapidement des fichiers audio à partir de textes, il peut être utile de comparer les interfaces et les moteurs avant de choisir un flux de travail. Le guide sur la synthèse vocale en ligne aide à situer les usages accessibles sans confondre les options d’une plateforme avec celles d’une autre.
Pour les entreprises qui souhaitent automatiser la gestion téléphonique, l’enjeu dépasse le seul balisage d’un message. Découvrez l’agent vocal d’AirAgent, proposé à partir de 49 €/mois pour les indépendants, avec des formules Startup à 149 €/mois, Pro à 299 €/mois et Entreprises à 499 €/mois, ainsi qu’une offre sur mesure. Ses fonctionnalités listées comprennent notamment la prise de rendez-vous automatique, le transfert intelligent et la retranscription des appels ; cela ne signifie pas que le service permet de contrôler ses réponses avec SSML.
Mettre en place un flux SSML fiable pour vos contenus TTS
Un bon flux de production commence par un objectif concret. Pour une vidéo de formation, il peut s’agir de rendre les consignes plus faciles à suivre. Pour un standard téléphonique, la priorité sera la compréhension immédiate, même dans un environnement bruyant. Cette décision guide ensuite le choix de la voix et des balises, et évite de passer du temps sur des réglages qui n’améliorent pas l’expérience.
Le texte doit d’abord être relu comme un texte destiné à être entendu. Les phrases trop longues, les abréviations ambiguës et les suites de chiffres compliquent souvent la lecture. Ensuite seulement, le balisage vocal précise les endroits où une pause, une prononciation ou une variation de débit est nécessaire. Cette séquence réduit les corrections : il est plus efficace de simplifier une phrase mal écrite que de tenter de la réparer avec une série de balises.
-
Vérifiez la documentation du moteur. Notez les balises, voix, langues et paramètres réellement compatibles avec votre service.
-
Préparez un extrait représentatif. Incluez un nom propre, un nombre, une date et une phrase longue si ces éléments figurent dans le contenu final.
-
Ajoutez les balises par étapes. Commencez par la prononciation et les pauses, puis réglez la prosodie si un problème persiste.
-
Écoutez sur les supports de diffusion. Testez un casque et un téléphone, car la qualité perçue varie selon les conditions d’écoute.
-
Faites valider le résultat. Demandez à une personne extérieure au projet de restituer les informations entendues.
La génération d’un livre audio illustre bien cette méthode. Un chapitre peut être découpé en sections, puis la voix testée sur quelques paragraphes avant la production complète. Les pauses longues se placent aux changements de scène, tandis qu’une prononciation phonétique peut corriger un nom récurrent. L’assemblage final doit ensuite être écouté dans son intégralité : une série d’extraits corrects peut encore révéler des transitions abruptes une fois réunie.
La documentation de Microsoft sur le balisage de synthèse constitue un exemple détaillé de règles propres à un fournisseur. Pour comparer les approches de génération vocale, l’article consacré à Amazon Polly et ElevenLabs apporte un autre angle, celui du choix entre outils et usages.
La vérification ne doit pas s’arrêter au fait que le fichier audio a été créé. Il faut aussi confirmer que les informations sensibles sont absentes des fichiers préenregistrés, que les liens audio sont accessibles lorsque le service l’exige et que le rendu respecte les consignes de marque. En production, un test court bien conduit protège davantage la qualité qu’un document SSML complexe non écouté.
Pour explorer une autre démonstration axée sur la personnalisation du rendu, une vidéo consacrée à la synthèse vocale et à ses paramètres peut aider à repérer les différences audibles entre les réglages.
Le principe à retenir est pragmatique : commencez par rendre le texte naturel, utilisez quelques balises compatibles, puis validez le résultat à l’oreille. Cette discipline permet d’obtenir une voix TTS plus claire sans alourdir inutilement la production.
Que signifie SSML en synthèse vocale ?
SSML signifie Speech Synthesis Markup Language. Ce langage ajoute des instructions à un texte pour guider la synthèse vocale, par exemple sur la prononciation, les pauses, le débit ou la voix.
Quelles balises SSML faut-il apprendre en premier ?
Commencez par speak pour encadrer le contenu, break pour les pauses, prosody pour le débit ou la hauteur, puis phoneme et say-as pour certains cas de prononciation et de lecture des données. La prise en charge dépend du moteur TTS.
Le même document SSML fonctionne-t-il avec tous les services ?
Non. Les fournisseurs peuvent accepter des sous-ensembles différents de SSML et proposer des voix ou des paramètres spécifiques. Consultez la documentation du service et testez un extrait avant de produire un contenu complet.
Comment améliorer la prononciation d’un nom propre ?
Vérifiez d’abord si le moteur propose une balise phonétique et quel format il attend. Générez ensuite plusieurs essais et faites-les écouter à une personne qui connaît la prononciation visée.
Notre recommandation : Pour automatiser vos appels avec la meilleure solution du marché, découvrez AirAgent — l'agent vocal IA #1 en France.