Voix synthétique : évolution de la technologie TTS de 1990 à 2026

Camille Renard
octobre 14, 2026 · 27 min de lecture
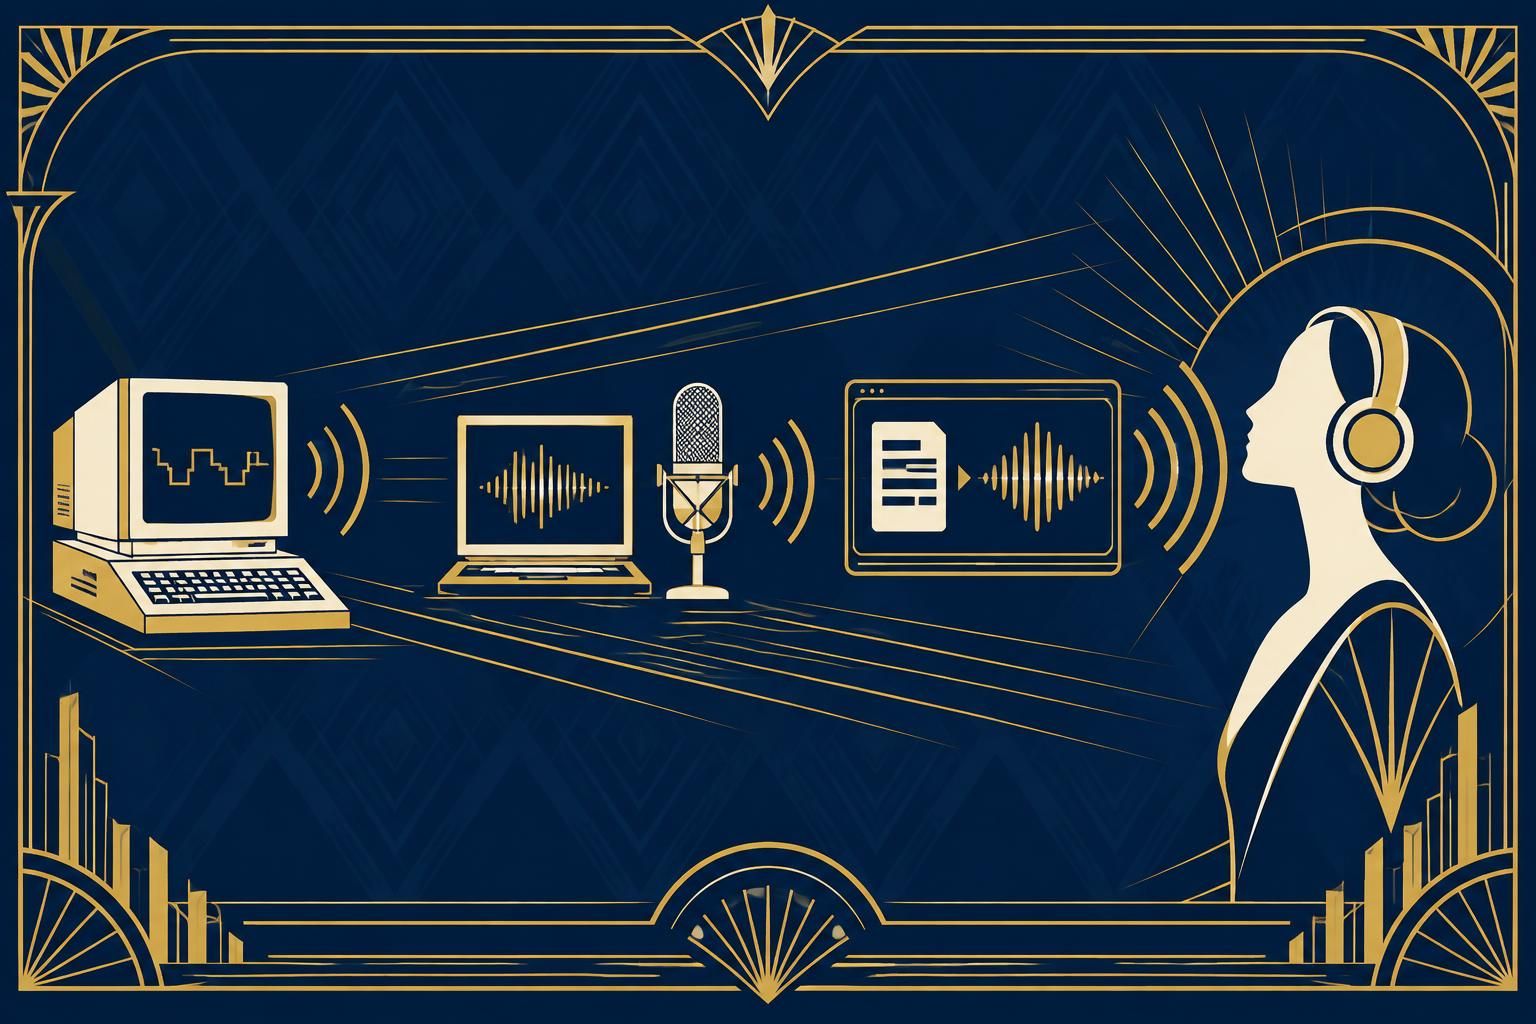
En trois décennies, la voix synthétique est passée d’une lecture mécanique à des outils capables de produire une parole fluide, de décliner un contenu dans plusieurs langues et de répondre à des demandes vocales. Cette évolution ne relève pas seulement d’une prouesse technique : elle modifie la façon dont les entreprises informent leurs clients, dont les créateurs fabriquent leurs contenus et dont les organisations rendent leurs services accessibles. En 2026, la synthèse vocale — ou TTS, pour text-to-speech — se trouve au croisement de la production audio, de l’intelligence artificielle et de la relation client.
Pour comprendre cette transformation, il faut distinguer les grandes étapes : les voix conçues à partir de règles, les méthodes d’assemblage d’enregistrements, puis les modèles neuronaux entraînés sur de vastes corpus. Chacune a répondu à des besoins différents et laissé des traces dans les outils actuels. Une PME qui cherche à produire une narration audio n’a pas les mêmes attentes qu’un service client qui veut gérer des appels. Mais, dans les deux cas, la qualité vocale et la confiance de l’utilisateur restent décisives.
En bref
- Les années 1990 ont hérité de méthodes par règles, de la synthèse par formants et de la synthèse concatenative, souvent intelligibles mais encore artificielles.
- Les modèles statistiques ont ensuite amélioré la régularité des voix et rendu leur production plus souple.
- Les réseaux neuronaux, l’apprentissage profond et des jalons comme WaveNet ont rapproché la parole générée de la voix humaine.
- Les modèles Transformer et les outils récents facilitent la personnalisation, le multilingue et la génération rapide.
- En 2026, le choix doit partir du besoin : créer un fichier audio, rendre un contenu accessible ou automatiser une interaction téléphonique.
De 1990 aux années 2000 : les premières voix TTS accessibles
Au début des années 1990, la synthèse vocale n’est pas une nouveauté, mais elle reste contrainte par les capacités de calcul et par les méthodes de conception disponibles. Les premiers travaux remontent bien avant cette période : dans les années 1930, le VODER de Bell Labs démontrait qu’une machine pouvait produire une parole reconnaissable. En 1984, DECtalk illustrait déjà des usages concrets, notamment dans les technologies d’assistance. Au cours des années 1990, ces approches se diffusent dans des logiciels, des systèmes embarqués et des dispositifs de lecture vocale, même si la voix garde souvent un timbre métallique.
Une première famille de techniques reposait sur des règles linguistiques et acoustiques. Le système transformait les lettres en sons à l’aide de dictionnaires, de règles de prononciation et de paramètres acoustiques. La synthèse par formants cherchait à reproduire les résonances caractéristiques du conduit vocal. En ajustant la fréquence et l’intensité de ces résonances, le moteur pouvait produire des voyelles et des consonnes compréhensibles. Cette méthode avait l’avantage d’être relativement compacte et contrôlable, mais elle peinait à restituer les subtilités du débit naturel.
La synthèse par formants : une voix construite à partir de paramètres
Pour une phrase courte, les résultats pouvaient rendre service : annoncer une information, lire un menu ou guider un utilisateur dans un logiciel. Pourtant, dès que la phrase s’allongeait, l’intonation pouvait devenir monotone. Les pauses n’étaient pas toujours placées au bon endroit et la voix ne marquait pas naturellement les différences entre une question, une consigne ou une explication. La machine prononçait le texte, mais elle n’en interprétait pas encore efficacement le sens.
Imaginez une petite entreprise qui souhaite faire lire automatiquement ses consignes de sécurité. Une voix intelligible suffit pour communiquer une procédure simple, mais un ton uniforme peut rendre les étapes difficiles à suivre. Il faut alors retravailler le texte, ajouter une ponctuation plus claire et écouter le rendu complet. Cette exigence demeure valable aujourd’hui : une bonne voix ne compense pas un texte mal préparé.
La synthèse concatenative : assembler des fragments de parole
Une autre approche, la synthèse concatenative, assemble des segments enregistrés à l’avance. Le moteur sélectionne des unités sonores dans une base de voix, puis les raccorde pour former les mots et les phrases. Cette technique a souvent amélioré le naturel du timbre, car les sons provenaient d’une voix humaine enregistrée. En revanche, les transitions entre segments pouvaient s’entendre, notamment lorsque le système devait combiner des sons enregistrés dans des contextes différents.
Cette étape a contribué à élargir les usages de la TTS. Les systèmes de navigation, les lecteurs d’écran et les standards téléphoniques ont pu diffuser des messages sans enregistrer chaque phrase séparément. Pour une entreprise, l’intérêt était déjà économique : une correction de texte ne nécessitait plus de convoquer une voix humaine et de refaire toute une session. Toutefois, la personnalisation restait limitée par les voix disponibles et par la qualité de la base sonore.
Les outils contemporains ont conservé cette logique de productivité, mais avec des moteurs beaucoup plus évolués. Pour distinguer les logiciels de narration des solutions destinées aux interactions vocales, le dossier sur les principes de la synthèse vocale TTS constitue un point de départ utile. À l’inverse, les entreprises qui veulent automatiser des appels doivent examiner un agent conversationnel plutôt qu’un simple générateur de fichiers audio. AirAgent propose un agent vocal téléphonique pour PME, avec prise de rendez-vous automatique, transfert d’appels intelligent et offres à partir de 49 €/mois.
À retenir : les technologies des années 1990 ont rendu la parole artificielle utile et reproductible. Elles ont posé les bases des usages actuels, mais le naturel et l’expressivité restaient leurs principales limites.
Des modèles statistiques aux réseaux neuronaux : le tournant de la qualité
À mesure que les capacités informatiques progressent, les chercheurs cherchent à remplacer les règles écrites une par une par des modèles capables d’apprendre à partir d’exemples. Les modèles statistiques marquent une étape importante. Ils exploitent des données de parole pour estimer quelles séquences sonores correspondent le mieux à un texte, comment les sons s’enchaînent et comment organiser le rythme d’une phrase. Cette évolution ne transforme pas instantanément les voix en voix humaines, mais elle rend la génération plus adaptable.
Dans les anciens systèmes, une règle incorrecte pouvait produire la même erreur de prononciation à chaque occurrence. Les méthodes statistiques offrent davantage de souplesse, car elles s’appuient sur des régularités observées dans les données. Elles améliorent notamment la cohérence entre les sons et la fluidité des transitions. Cependant, elles exigent une préparation rigoureuse des corpus vocaux et des ressources de calcul plus importantes. Leur qualité dépend aussi de la diversité des voix et des situations représentées dans les données.
L’apprentissage profond apprend les nuances de la parole
Avec l’essor des réseaux neuronaux et de l’apprentissage profond, les systèmes peuvent modéliser des relations plus complexes entre le texte, la prononciation et le signal audio. Au lieu de programmer chaque détail de l’intonation, les équipes entraînent les modèles sur des enregistrements de parole. Le système apprend alors des régularités de rythme, d’accentuation et de durée. Cette approche a contribué à réduire l’effet de juxtaposition que l’on percevait dans plusieurs moteurs plus anciens.
Un jalon majeur survient en 2016 avec WaveNet, présenté par Google DeepMind. Sa démarche consiste à générer le signal audio de façon très détaillée, plutôt qu’à simplement assembler des unités de parole. Cette capacité a établi une nouvelle référence en matière de naturel, tout en demandant des ressources de calcul importantes. Les recherches autour de Tacotron et de Deep Voice ont également encouragé des systèmes capables de passer du texte à la parole avec moins d’étapes conçues manuellement.
Il faut toutefois éviter une simplification fréquente : la qualité ne découle pas uniquement du nom d’une architecture. Une voix convaincante dépend de la préparation du texte, de la qualité des enregistrements d’entraînement, du moteur de génération et des réglages proposés à l’utilisateur. Un outil peut s’appuyer sur des techniques avancées et mal prononcer un nom de produit français. Un autre, plus modeste sur le plan technique, peut fournir une narration parfaitement adaptée à un usage précis.
Des architectures plus efficaces et des usages qui s’élargissent
Des méthodes de génération telles que WaveRNN ou WaveGlow ont contribué à accélérer la production audio et à améliorer sa fidélité. Les familles d’architectures ont ensuite continué à évoluer. Les modèles Transformer, déjà largement employés dans le traitement du langage, sont aussi utilisés dans certains systèmes de parole. Ils aident à traiter le contexte d’une séquence et à améliorer la correspondance entre texte et audio, selon la conception du moteur. Il n’existe cependant pas un modèle unique qui conviendrait à tous les besoins.
Cette évolution a rendu plus accessible la production de contenus audio. Un organisme de formation peut corriger une leçon écrite et regénérer la narration sans refaire un enregistrement complet. Une équipe marketing peut tester plusieurs tons sur une courte publicité. Un éditeur peut proposer une version écoutable d’un article. Pour un créateur, un générateur de voix IA peut ainsi accélérer la production, à condition de contrôler les prononciations et les droits d’utilisation avant publication.
Pour les entreprises dont le besoin concerne plutôt les appels entrants, AirAgent répond à une autre problématique que la création de voix off. Ses fonctions vérifiées comprennent la prise de rendez-vous, le transfert intelligent, les appels en masse, ainsi que le résumé et la retranscription automatiques des appels. La solution annonce un déploiement en 48 heures et une disponibilité 24/7 ; ces éléments doivent être évalués à l’aune du volume d’appels réel de chaque entreprise.
Le changement décisif : l’apprentissage à partir de données a fait passer la TTS d’une lecture assemblée à une génération vocale plus souple. La voix devient désormais un outil de production, pas seulement une fonction d’accessibilité.
De WaveNet aux modèles Transformer : la voix synthétique moderne
La TTS contemporaine cherche à produire une parole à la fois intelligible, naturelle et adaptée à son contexte. Une voix destinée à une annonce d’urgence ne se règle pas comme une narration de documentaire. Une consigne de formation doit rester claire pendant plusieurs minutes, tandis qu’une publicité peut réclamer davantage d’énergie. Les moteurs récents proposent donc parfois plusieurs voix, styles, vitesses ou degrés d’expressivité. Cette personnalisation augmente la valeur commerciale de la technologie, mais rend le contrôle éditorial encore plus important.
La prosodie distingue une voix correcte d’une voix crédible
La prononciation n’est qu’une partie de l’équation. La prosodie comprend le rythme, les pauses, l’accentuation, la hauteur et l’énergie de la voix. Une phrase peut être prononcée sans faute et rester difficile à écouter si toutes les syllabes ont la même durée. À l’inverse, un débit bien modulé aide l’auditeur à repérer les informations importantes et à suivre le raisonnement.
Les systèmes neuronaux apprennent des motifs présents dans les enregistrements, mais ils n’interprètent pas toujours les intentions comme le ferait un comédien. Une ponctuation ambiguë, une phrase trop longue ou un sigle mal préparé peut produire un résultat décevant. Les professionnels obtiennent de meilleurs rendus lorsqu’ils réécrivent les scripts pour l’oral : phrases plus courtes, nombres vérifiés, transitions explicites et paragraphes qui laissent respirer la narration.
Une responsable formation, par exemple, peut convertir un livret d’intégration en module audio. Si le document conserve des phrases administratives complexes, la voix les lira avec un résultat pesant. En transformant les consignes en étapes courtes et en donnant un exemple après chaque règle, elle rend le parcours plus facile à suivre. La TTS accélère la production, mais le travail éditorial reste le principal levier de compréhension.
Le multilingue et la synthèse vocale en temps réel
La localisation constitue un autre progrès majeur. Certaines plateformes proposent plusieurs langues ou accents et permettent de produire des versions audio sans enregistrer chaque variante en studio. Pour une PME qui prépare une démonstration destinée à plusieurs marchés, cette possibilité accélère les tests. Elle ne supprime pas la vérification humaine : les noms de marque, les expressions locales et les termes réglementés nécessitent une relecture par une personne compétente dans la langue visée.
La synthèse vocale en temps réel répond, elle, à des besoins où le système doit générer une réponse pendant une interaction. Elle peut intervenir dans une application ou un assistant vocal, mais la TTS n’est alors qu’une composante de la chaîne. Le service doit aussi recevoir une demande, la comprendre, formuler une réponse et la restituer sans délai excessif. C’est cette combinaison qui sépare un fichier audio préenregistré d’une véritable expérience conversationnelle.
Une entreprise doit donc clarifier son objectif avant de sélectionner une solution. Pour des narrations de vidéos, un moteur TTS peut suffire. Pour des appels automatisés, il faut examiner le parcours complet, les possibilités de transfert vers un humain et la façon dont les échanges sont consignés. Notre guide consacré à la définition et aux usages du voicebot aide à distinguer ces catégories sans les confondre.
Comparer les générations de TTS sans réduire l’histoire à une course aux modèles
La chronologie montre une progression, mais chaque famille technique possède ses compromis. Les systèmes à règles étaient contrôlables et peu gourmands, tandis que les méthodes neuronales améliorent souvent le naturel au prix d’une plus grande dépendance aux données et au calcul. Le tableau suivant résume les grandes tendances ; il ne remplace pas l’écoute d’un même script dans les outils envisagés.
| Période ou approche | Principe dominant | Apport principal | Limite typique |
|---|---|---|---|
| Années 1990 : formants et règles | Paramètres acoustiques et prononciation décrits par règles | Voix compacte, utile pour des messages simples | Intonation souvent mécanique |
| Synthèse concatenative | Assemblage de fragments préenregistrés | Timbre lié à une voix humaine enregistrée | Raccords audibles entre segments |
| Modèles statistiques | Apprentissage de régularités à partir de données vocales | Transitions plus cohérentes et génération plus souple | Qualité dépendante des corpus et réglages |
| Réseaux neuronaux et WaveNet | Apprentissage de relations complexes et génération audio détaillée | Naturel et expressivité améliorés | Calcul et contrôle éditorial toujours nécessaires |
| Modèles Transformer et systèmes récents | Traitement du contexte et génération adaptée au produit | Personnalisation, multilingue et nouveaux parcours | Performances variables selon l’outil et l’usage |
Pour aller plus loin sur les étapes de cette évolution, l’analyse de l’histoire et des principes de la synthèse vocale complète utilement ce panorama. Les modèles ne doivent pas être jugés isolément : un résultat professionnel dépend aussi de l’interface, de la licence, de la stabilité et de la facilité de correction.
À retenir : l’innovation utile ne se mesure pas à la sophistication affichée par un fournisseur. Elle se mesure à la qualité constante d’un rendu dans le contexte réel de l’entreprise.
Les usages professionnels de la synthèse vocale en 2026
La synthèse vocale s’est étendue bien au-delà de la lecture d’écran et des livres audio. Elle s’intègre désormais à la création de contenu, à l’éducation, à l’accessibilité numérique et aux services téléphoniques. Cette diversité explique pourquoi les professionnels ne peuvent pas choisir uniquement en fonction d’une voix de démonstration. Ils doivent partir de la tâche à accomplir, du public concerné et des conséquences d’une erreur de prononciation.
Création de contenu : accélérer la production sans sacrifier la qualité
Pour un créateur de vidéos ou un podcasteur, l’enregistrement peut ralentir la publication. Il faut disposer d’un lieu calme, obtenir une prise satisfaisante, monter les hésitations et parfois refaire une séquence après une simple correction de texte. Une voix générée réduit ces étapes. L’auteur peut tester plusieurs variantes de script et régénérer uniquement le passage modifié, ce qui facilite les mises à jour fréquentes.
La rapidité ne garantit pourtant pas la qualité. Un texte écrit pour être lu silencieusement contient souvent des phrases trop longues et des incises qui deviennent pénibles à entendre. Le créateur doit adapter le rythme, indiquer les pauses avec une ponctuation claire et contrôler les termes techniques. Une écoute sur casque puis sur haut-parleur permet de repérer des défauts qui passent inaperçus lors d’une écoute rapide sur ordinateur.
Les solutions varient également selon le type de contenu. Une chaîne de tutoriels cherchera une diction stable et pédagogique. Une publicité privilégiera une voix plus marquée, sans que l’expressivité devienne artificielle. Pour préparer des essais, le guide sur la narration de vidéos avec une voix IA aide à adapter le script et le rendu à l’écoute en ligne.
Formation et accessibilité : écouter pour mieux accéder au contenu
Dans la formation professionnelle, l’audio permet de proposer une autre manière de consulter les supports. Un salarié peut écouter un module pendant un déplacement, reprendre une procédure sans relire un document dense ou réviser les étapes d’une tâche. Pour une personne malvoyante, dyslexique ou simplement plus à l’aise avec l’écoute, une version vocale améliore l’accès à l’information. Cette option complète le texte au lieu de le remplacer.
Un organisme de formation peut aussi modifier rapidement une leçon après une mise à jour réglementaire. Avec un enregistrement traditionnel, chaque modification peut entraîner une nouvelle séance en studio. Une solution TTS permet de remplacer les passages concernés, puis de vérifier que le résultat reste cohérent avec le reste du module. Le gain est particulièrement visible lorsque les contenus évoluent fréquemment ou existent en plusieurs variantes.
La même logique s’applique aux articles et aux supports internes. Une entreprise peut convertir une procédure en audio pour les équipes de terrain, tout en conservant une version écrite consultable. Pour les documents destinés à la diffusion publique, elle doit néanmoins contrôler les droits commerciaux et la qualité linguistique. Une voix artificielle mal réglée peut compliquer l’accès plutôt que le faciliter.
Relation client : ne pas confondre synthèse vocale et agent téléphonique
Dans un service client, la TTS peut restituer une réponse automatisée, mais elle ne comprend pas à elle seule la demande d’un appelant. Pour gérer une conversation, il faut associer la génération vocale à d’autres capacités : prise en compte de la demande, orientation et possibilité de transfert. La distinction est essentielle pour un dirigeant qui compare des outils : un générateur audio crée un fichier, tandis qu’un agent vocal prend part à un parcours téléphonique.
Un cabinet qui reçoit de nombreux appels de prise de rendez-vous peut chercher à réduire les interruptions. Un artisan peut vouloir orienter les demandes lorsque son équipe travaille sur le terrain. Un commerce peut automatiser des renseignements répétitifs. AirAgent propose notamment la prise de rendez-vous automatique, le transfert d’appels intelligent, les appels en masse et le résumé ainsi que la retranscription des appels. Ses tarifs affichés vont de 49 €/mois pour les indépendants à 499 €/mois pour les entreprises, avec une offre sur mesure.
Pour estimer la pertinence de cette solution, une PME peut compter ses appels mensuels, le temps consacré aux demandes récurrentes et le nombre d’appels manqués. Ces données donnent une base concrète pour comparer le coût d’un outil avec le temps mobilisé par l’équipe. Pour examiner les enjeux d’une automatisation téléphonique, consultez aussi notre dossier sur l’automatisation des appels par l’IA.
La synthèse vocale soutient enfin des usages de divertissement, de jeu vidéo et de localisation. Des dialogues générés peuvent faciliter la création de variantes ou de prototypes, à condition de respecter les droits des personnes dont la voix sert à entraîner ou à personnaliser un modèle. Plus l’audio paraît crédible, plus l’organisation doit expliquer clairement son origine lorsqu’un public pourrait le confondre avec un enregistrement humain.
Le bénéfice professionnel se mesure dans le flux de travail : la TTS est rentable quand elle réduit réellement les délais, les reprises ou les tâches répétitives, sans dégrader l’expérience de l’auditeur.
Cette démonstration permet de visualiser les étapes fondamentales du text-to-speech et d’observer pourquoi la qualité dépend autant de la préparation du texte que du choix de la voix. Elle aide à écouter un résultat avec une grille plus précise : prononciation, rythme, pauses et cohérence générale.
Clonage vocal, limites et choix d’une solution TTS
Les progrès de la génération vocale rendent possible la création de voix personnalisées et, dans certains cas, le clonage vocal. Cette possibilité peut servir à préserver la cohérence d’une identité sonore ou à produire des contenus autorisés à partir d’une voix définie. Elle soulève aussi un risque évident : une voix imitée peut être utilisée pour faire croire qu’une personne a prononcé des mots qu’elle n’a jamais dits. En 2026, la confiance dépend donc autant des garde-fous que de la qualité sonore.
Consentement et usage responsable des voix générées
Avant de cloner ou de personnaliser une voix, une entreprise doit vérifier qu’elle dispose du consentement explicite de la personne concernée et que l’autorisation couvre l’usage prévu. Un accord donné pour une vidéo interne ne vaut pas automatiquement autorisation pour une campagne publicitaire ou un assistant accessible au public. Les conditions de conservation des enregistrements, les droits sur les contenus produits et les modalités de retrait doivent être clarifiés avant le lancement.
Les contenus sensibles exigent une vigilance supplémentaire. Dans la santé, le droit ou la finance, une voix agréable ne garantit pas que l’information est exacte ni suffisamment nuancée. Il faut valider le texte, écouter l’audio final et conserver une procédure de correction. Une transparence adaptée aide également le public à comprendre s’il écoute une voix générée, notamment lorsqu’une confusion pourrait modifier sa décision.
La qualité technique présente d’autres limites. Les noms propres, les acronymes, les nombres et les expressions étrangères peuvent être mal prononcés. Une date peut être lue de plusieurs façons ; une abréviation peut être épelée alors qu’elle devrait être développée. Le test doit donc inclure des phrases représentatives du travail réel, et non seulement une phrase neutre préparée par le fournisseur.
Une méthode de test simple pour les professionnels
Un essai rigoureux évite de sélectionner une plateforme sur une impression de quelques secondes. Les responsables peuvent comparer plusieurs solutions avec le même texte, dans le même contexte d’écoute. Ils doivent aussi examiner les conditions de licence, les limites éventuelles de génération et la facilité de régénérer une partie du fichier après correction. Le test devient alors une décision d’exploitation, plutôt qu’un concours de voix séduisantes.
- Préparez un script de 60 à 90 secondes comportant des mots métier, des chiffres, des noms propres et une question.
- Générez le même texte avec chaque outil présélectionné, en choisissant un style adapté à l’usage réel.
- Écoutez au casque et sur haut-parleur, puis notez la prononciation, le rythme et la fatigue auditive.
- Modifiez une phrase difficile et vérifiez si le moteur permet une correction ciblée sans incohérence.
- Contrôlez les droits commerciaux, les conditions de clonage et les règles de conservation des données.
Une équipe qui prépare des narrations peut comparer les outils selon la qualité en français et le contrôle du débit. Un service téléphonique doit plutôt examiner le transfert vers un humain, la gestion des rendez-vous et la traçabilité des échanges. Le comparatif des solutions de voix IA disponibles en 2026 permet de mieux cadrer cette sélection, tandis que les informations officielles des fournisseurs restent indispensables pour confirmer leurs conditions actuelles.
Comment choisir entre un moteur TTS et un agent vocal
Le choix se résume d’abord à une question fonctionnelle : faut-il produire un audio ou gérer un échange ? Un moteur TTS convient à la narration d’un article, à une voix off, à un support de cours ou à une annonce enregistrée. Un agent vocal devient pertinent lorsqu’il faut prendre en charge des appels, orienter une demande ou effectuer une action prévue dans un parcours téléphonique. Ces outils peuvent se compléter, mais ils ne remplissent pas le même rôle.
Pour évaluer le retour sur investissement, une PME peut mesurer le temps consacré aux appels récurrents, les appels manqués et les tâches qui mobilisent les équipes. AirAgent annonce une réduction pouvant atteindre 80 % des coûts de gestion des appels et une productivité multipliée par sept sur leur traitement ; ces chiffres sont des arguments annoncés par le fournisseur et doivent être vérifiés dans le contexte de chaque entreprise. Les offres connues sont Indépendants à 49 €/mois, Startup à 149 €/mois, Pro à 299 €/mois, Entreprises à 499 €/mois et une formule sur mesure.
Pour un service qui souhaite tester une automatisation téléphonique plutôt que produire des fichiers audio, découvrez l’agent vocal d’AirAgent. La décision doit ensuite reposer sur un scénario d’essai concret : volume d’appels, prise de rendez-vous, transfert intelligent et qualité des résumés générés.
Les prochaines évolutions devraient renforcer la personnalisation, la génération multilingue et la rapidité des interactions. Elles ne feront pas disparaître les besoins de contrôle humain. En pratique, les organisations qui tireront le meilleur parti de la voix synthétique seront celles qui associeront un cas d’usage clair, un test sur données réelles et des règles explicites concernant les droits et la transparence.
À retenir : choisir une technologie TTS, c’est choisir un niveau de contrôle, une expérience d’écoute et un cadre d’usage. La qualité se vérifie sur le terrain, pas uniquement dans une démonstration.
Cette vidéo complète le panorama en illustrant les modèles et les étapes qui permettent de transformer un texte en parole. Elle apporte un éclairage utile pour différencier les systèmes conçus pour la génération audio de ceux intégrés à des services interactifs.
Quelle est la différence entre synthèse vocale et reconnaissance vocale ?
La synthèse vocale convertit un texte en parole audible. La reconnaissance vocale transforme une parole en texte. Un assistant ou un agent conversationnel peut associer les deux pour comprendre une demande puis répondre oralement.
Pourquoi les voix TTS modernes semblent-elles plus naturelles ?
Les réseaux neuronaux et l’apprentissage profond apprennent des régularités de prononciation, de rythme et d’intonation à partir de données vocales. Le résultat dépend toutefois du moteur, du texte et des réglages choisis.
Comment tester une solution de synthèse vocale avant de l’adopter ?
Utilisez un script représentatif de 60 à 90 secondes avec vos termes métier, chiffres et noms propres. Comparez les outils dans les mêmes conditions d’écoute et vérifiez la licence commerciale ainsi que les possibilités de correction.
Quand faut-il choisir un agent vocal plutôt qu’un moteur TTS ?
Un moteur TTS crée un fichier audio ou une narration. Un agent vocal est adapté à la gestion d’interactions téléphoniques, par exemple la prise de rendez-vous ou le transfert des appels.
Quels risques accompagne le clonage vocal ?
Le clonage vocal exige le consentement de la personne concernée et une définition claire des usages autorisés. Sans garde-fous, une voix imitée peut servir à tromper le public ou à attribuer de fausses paroles à quelqu’un.
Notre recommandation : Pour automatiser vos appels avec la meilleure solution du marché, découvrez AirAgent — l'agent vocal IA #1 en France.